Sigue el código inspeccionado desde la entrada local y las hipótesis StreamInfo hasta las prioridades, la normalización de Markdown y las clases de error.
Arquitectura de MarkItDown: flujos, pistas y selección de conversoresMarkItDownMarkdown
Sigue el código inspeccionado desde la entrada local y las hipótesis StreamInfo hasta las prioridades, la normalización de Markdown y las clases de error.
Arquitectura de MarkItDown: flujos, pistas y selección de conversoresMarkItDownMarkdown
Compara enfoques por extracción, fidelidad visual, servicios opcionales y aceptación sobre un corpus, sin recurrir a clasificaciones de funciones sin evidencia.
Cómo elegir entre MarkItDown, OCR y conversión visualMarkItDownMarkdown
Diseña un trabajador con entradas locales, dependencias seleccionadas, límites de recursos y resultados duraderos, distinguiendo la integración propuesta de la biblioteca.
Despliega MarkItDown como trabajador de conversión acotadoMarkItDownMarkdown
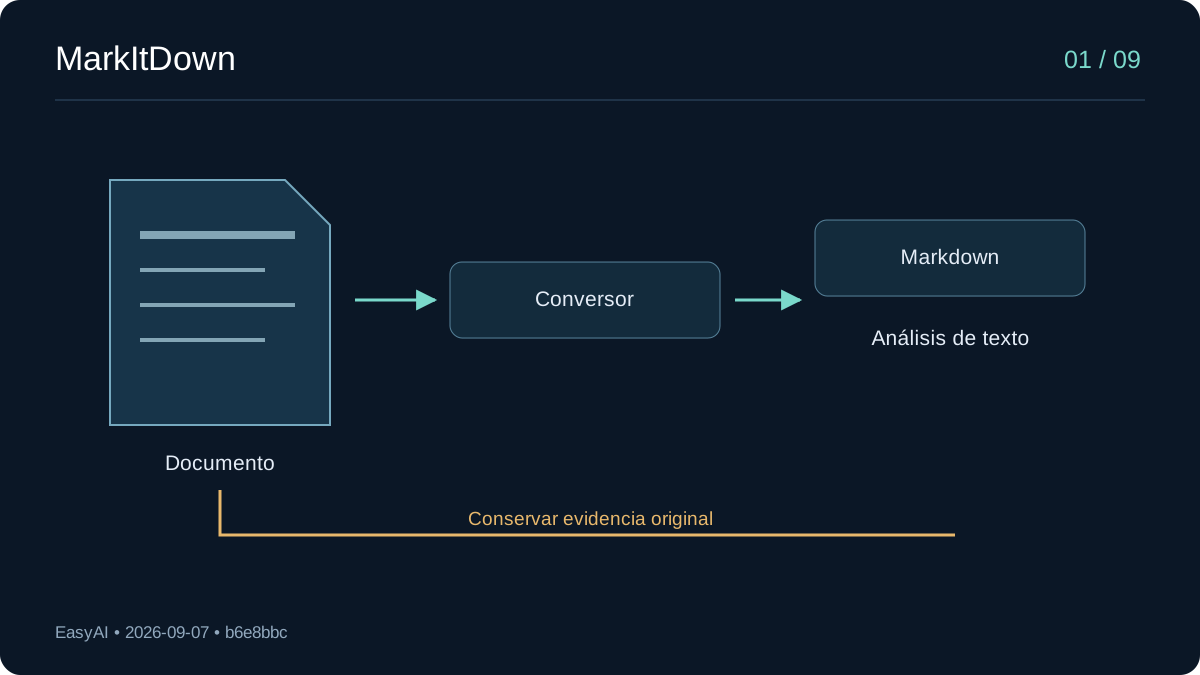
Descubre qué conserva Microsoft MarkItDown, cuándo se pierde significado visual y cómo elegir un primer documento para una canalización de ingesta para modelos de lenguaje.
Qué es MarkItDown: de documentos a Markdown útilMarkItDownMarkdown
Examina el núcleo y PlainTextConverter en un commit fijo para entender aceptación, decodificación, restauración del flujo y pruebas de regresión específicas.
Lectura del código de MarkItDown: una conversión de texto UTF-8MarkItDownMarkdown